
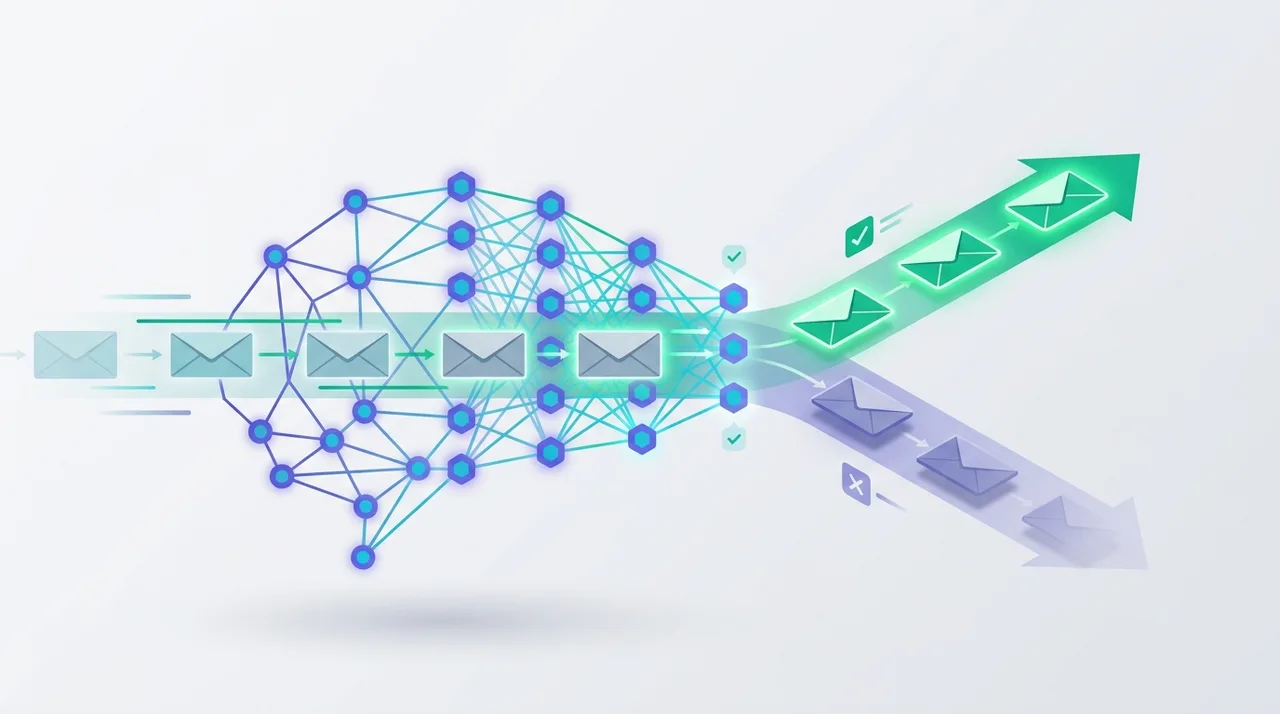
Per gran parte della sua storia, la validazione email è stata una checklist. La sintassi è corretta? Il dominio esiste? Pubblica record MX? Il server di posta accetta l'indirizzo durante una conversazione SMTP? Si esegue la checklist, si timbra l'indirizzo come valido o non valido e si passa oltre. Quel modello ha funzionato egregiamente per anni — poi il panorama email lo ha silenziosamente superato.
Oggi una quota significativa degli indirizzi presenti in qualsiasi lista reale non può essere decisa dalle regole. I server catch-all dicono sì a tutto. I server con greylisting rispondono a tutti "riprova più tardi". I provider di email usa e getta creano nuovi domini più in fretta di quanto le blocklist riescano a registrarli. I bot inviano a milioni indirizzi sintatticamente perfetti e dall'aspetto plausibile. È questo il vuoto che oggi colmano intelligenza artificiale e machine learning: non sostituendo i controlli deterministici che decidono ancora la maggior parte degli indirizzi, ma assegnando un punteggio alla crescente zona grigia che quei controlli non riescono a risolvere. Questo articolo spiega come funziona questo cambiamento, perché ha modificato il significato stesso di "accuratezza" e cosa dovresti chiedere a qualsiasi fornitore che dichiari oltre il 99%.
Punto Chiave
I controlli deterministici (sintassi, DNS, MX, SMTP) decidono ancora la netta maggioranza degli indirizzi — ed è giusto così. Il machine learning trova il suo spazio nella zona grigia: catch-all, server con greylisting, domini nuovi e indirizzi generati da bot, dove le regole possono rispondere solo "sconosciuto". I servizi moderni combinano entrambi, sostituendo i verdetti binari con punteggi di rischio calibrati che migliorano continuamente man mano che gli esiti reali di consegna alimentano i modelli.
Il Limite della Validazione Basata su Regole
Per capire cosa aggiunge il machine learning, partiamo da ciò che la pipeline classica fa già bene. La validazione deterministica è veloce, economica, spiegabile e — per le domande a cui sa rispondere — praticamente perfetta.
Cosa decidono in modo conclusivo i controlli deterministici
- Sintassi: un indirizzo che viola le regole di formato non potrà mai ricevere posta. Non valido, con certezza.
- Dominio e DNS: se il dominio non si risolve o non pubblica record MX, lì non si può consegnare nulla. Non valido, con certezza.
- Verifica SMTP della casella: quando un server ben configurato risponde "550 5.1.1 — la casella non esiste", la questione è chiusa.
- Consultazione di liste note: domini usa e getta confermati, account di ruolo come info@ o billing@ e altre categorie riconoscibili tramite pattern.
Dove le regole binarie esauriscono le risposte
Il problema è l'insieme di indirizzi per i quali la checklist non restituisce alcun verdetto — e quell'insieme cresce da un decennio:
- Domini catch-all: il server accetta posta per qualsiasi indirizzo, reale o inventato. Un "accettato" SMTP da un server catch-all non prova nulla sull'esistenza della casella. Le regole possono rilevare che un dominio è catch-all; non possono dirti se un indirizzo specifico su quel dominio verrà consegnato.
- Greylisting: molti server rinviano deliberatamente il primo tentativo di consegna da un mittente sconosciuto. Per un verificatore ingenuo, un indirizzo perfettamente valido appare temporaneamente non recapitabile.
- Ambiguità tra casella piena e errori temporanei: una risposta 4xx significa "non adesso" — ma si tratta di una casella momentaneamente piena su un account attivo, o di una casella abbandonata e piena da tre anni? Il solo codice SMTP non può dirlo.
- Domini usa e getta appena creati: una blocklist statica è, per definizione, un registro del passato. Un dominio temporaneo registrato stamattina supera oggi ogni controllo basato su liste.
- Falsi plausibili: bot e truffatori hanno smesso da tempo di digitare caratteri a caso. Un indirizzo inventato costruito con un nome reale, un cognome reale e un dominio aziendale reale supera la sintassi, il DNS e — su un server catch-all — anche l'SMTP.
Forzare questi casi in una risposta binaria produce esattamente le due modalità di errore di cui i mittenti si lamentano: indirizzi "validi" che generano bounce e iscritti reali scartati come "non validi". L'output onesto per la zona grigia non è un verdetto — è una probabilità.
Perché il Problema Diventa Sempre Più Difficile
La zona grigia non è statica, e nemmeno la tua lista. Le ricerche di settore documentano da anni quanto rapidamente si degradano i dati email e quanto costa questo degrado:
Ogni anno circa un quinto di una lista tipica si rinnova, perché le persone cambiano lavoro, abbandonano caselle e passano ad altri provider. Nel frattempo l'offerta di indirizzi ingannevoli continua ad aumentare: i servizi di email usa e getta sono diventati un settore di dimensioni considerevoli, e alcuni ruotano i propri domini così rapidamente che una voce di blocklist può diventare obsoleta pochi giorni dopo la pubblicazione. Un approccio alla validazione fermo a "controlla la lista, interroga il server" resta un po' più indietro ogni mese. È questa la ragione strutturale per cui il settore si è spostato verso sistemi che apprendono.
Cosa Aggiunge Davvero il Machine Learning
Il contributo principale del ML alla validazione email è un cambiamento dell'output: dai verdetti binari ai punteggi di rischio calibrati. Invece di imporre "valido o non valido" a un indirizzo ambiguo, un modello stima la probabilità che la posta inviata venga accettata e raggiunga una casella reale e monitorata — ed esprime questa stima come un punteggio su cui puoi agire.
I segnali da cui apprendono i modelli
In tutto il settore, i sistemi di validazione assistiti dal ML vengono addestrati su famiglie di segnali sostanzialmente simili — tutti osservabili, nessuno dei quali richiede l'accesso alla casella di qualcuno:
- Pattern di infrastruttura del dominio: come è configurato e predisposto il sistema di posta di un dominio — il tipo di hosting, la completezza dei record DNS, se il suo profilo somiglia a un'infrastruttura aziendale consolidata o a un dominio temporaneo registrato in fretta.
- Esiti storici di consegna: come si sono effettivamente comportati gli indirizzi dello stesso dominio, o con caratteristiche simili — accettati, hard bounce, soft bounce — su grandi volumi di traffico di verifica passato.
- Comportamento nel tempo: pattern temporali, come l'età di un dominio, la stabilità della sua configurazione e la coerenza o irregolarità delle sue risposte. L'infrastruttura legittima tende a essere noiosa; quella usata per abusi tende a cambiare di continuo.
- Comportamento nella conversazione SMTP: non solo il codice di risposta finale, ma come si comporta un server durante lo scambio — una ricca fonte di caratteristiche per distinguere, ad esempio, un autentico catch-all aziendale da un relay compiacente verso lo spam che accetta tutto.
- Modelli probabilistici degli errori di battitura: modelli statistici degli errori di tastiera e degli errori ortografici comuni, che riconoscono "gamil.com" come un "gmail.com" digitato male anziché come un nuovo provider esotico, e possono proporre la correzione desiderata.
Scoring d'insieme e calibrazione
In pratica, nessun singolo modello decide da solo. Lo schema standard del settore è un ensemble: più modelli, ciascuno forte su una porzione diversa del problema — uno specializzato nella reputazione dei domini, un altro nella probabilità di consegna sui catch-all, un altro ancora nel rilevamento di pattern di indirizzi generati automaticamente — i cui output vengono combinati in un unico punteggio. Altrettanto importante è la calibrazione: un punteggio di 90 dovrebbe significare che, empiricamente, circa nove indirizzi su dieci con punteggio 90 vengono davvero consegnati. È la calibrazione a trasformare l'opinione di un modello in un numero su cui un team marketing può costruire delle regole — ad esempio, "gli invii transazionali richiedono 95+, le campagne di riconquista accettano 70+".
La Questione dell'Accuratezza: Precisione, Recall e il Ciclo Continuo di Riaddestramento
Cosa nasconde l'"accuratezza"
Ogni fornitore pubblicizza una percentuale di accuratezza; pochi spiegano le due grandezze che contano davvero. In termini di validazione:
- La precisione chiede: tra gli indirizzi che abbiamo segnato come recapitabili, quanti lo erano davvero? Una precisione bassa significa bounce che ti era stato detto non sarebbero avvenuti — danni alla reputazione.
- Il recall chiede: tra gli indirizzi davvero recapitabili, quanti ne abbiamo correttamente mantenuti? Un recall basso significa iscritti reali, e ricavi reali, buttati via come falsi positivi.
Le due grandezze si muovono in direzioni opposte. Qualsiasi servizio può raggiungere una precisione quasi perfetta rifiutando in modo aggressivo tutto ciò che è ambiguo — al prezzo di scartare migliaia di contatti autentici. Qualsiasi servizio può raggiungere un recall quasi perfetto lasciando passare tutto. Un singolo numero in evidenza ha senso solo se riflette un equilibrio ragionevole tra le due, misurato sugli esiti reali di consegna e su un mix realistico di indirizzi, catch-all inclusi. Quando valuti un fornitore, chiedi quale compromesso rappresenta il suo numero.
Perché oltre il 99% richiede un riaddestramento continuo
Ecco la verità scomoda sulle dichiarazioni di accuratezza elevata: hanno una data di scadenza. La distribuzione su cui è stato addestrato un modello cambia continuamente — compaiono nuovi provider usa e getta, i software dei server di posta modificano il loro comportamento di risposta, le aziende migrano la propria infrastruttura email, interi domini di primo livello guadagnano o perdono affidabilità. Un modello addestrato una volta e poi lasciato a sé stesso riporterà l'accuratezza di ieri sul traffico di oggi; il settore chiama questo fenomeno model drift. Mantenere oltre il 99% in produzione è quindi più un risultato operativo che di modellazione: dati aggiornati sugli esiti in ingresso, modelli riaddestrati con cadenza regolare e prestazioni monitorate rispetto alla realtà anziché rispetto a un set di test che invecchia.
Cicli di Feedback: Imparare da Ciò che Ha Davvero Generato un Bounce
Il segnale di addestramento più prezioso in tutto questo campo è anche il più semplice: cosa è successo quando la posta è stata effettivamente inviata. Ogni hard bounce è un'etichetta di verità che dice "questo indirizzo non era recapitabile"; ogni consegna accettata è una prova più debole, ma comunque informativa, nella direzione opposta. I sistemi di validazione che chiudono questo ciclo — reimmettendo nei modelli gli esiti reali dei bounce — migliorano in modo misurabile proprio sui casi che le regole non possono decidere, perché per i catch-all e gli indirizzi della zona grigia gli esiti di consegna sono l'unica verità di riferimento disponibile.
È anche per questo che validazione e deliverability sono due metà della stessa disciplina. I dati sui bounce migliorano i modelli di rischio; modelli di rischio migliori tengono i bounce lontani dal tuo storico di reputazione; e una reputazione più pulita ti tiene fuori dalla cartella spam, come spiega in dettaglio la nostra guida completa alla deliverability email. Lo stesso ciclo protegge i mittenti dai classici killer silenziosi della reputazione — indirizzi obsoleti e spam trap — che per loro natura non si annunciano mai e possono essere evitati solo mantenendo aggiornati i modelli di rischio.
Il Lato Avversariale: Validare Contro Avversari che si Adattano
Il normale degrado dei dati è indifferente — le caselle muoiono perché le persone cambiano lavoro, non per farti un dispetto. Ma una parte del problema moderno della validazione è genuinamente avversariale: esistono attori ben finanziati il cui business dipende dal fatto che i loro indirizzi superino i tuoi controlli.
- I provider usa e getta ruotano i domini proprio per aggirare le blocklist. Alcuni alternano grandi lotti di domini nuovi secondo un calendario; i più aggressivi bruciano domini in meno di una settimana. Contro questo, le consultazioni di liste sono strutturalmente troppo lente — ma l'impronta infrastrutturale di un'operazione usa e getta (domini giovani, configurazione minima, pattern di hosting caratteristici, alto ricambio) è esattamente il tipo di segnale da cui un modello generalizza. Il modello può segnalare un dominio mai visto prima perché ne ha visti mille con la stessa forma.
- Le registrazioni dei bot sono diventate linguisticamente plausibili. La creazione automatizzata di account produce ormai indirizzi composti da nomi reali e domini reali, singolarmente indistinguibili da una registrazione umana per qualsiasi regola di sintassi. I modelli statistici se la cavano meglio perché gli indirizzi inventati sono generati da processi, e i processi lasciano impronte distributive — combinazioni nome-dominio improbabili e regolarità di pattern che si accumulano in una firma rilevabile anche quando ogni singolo indirizzo sembra innocuo.
Nessuno dovrebbe prometterti una vittoria definitiva: si tratta per natura di una corsa agli armamenti. L'affermazione realistica — e la ragione onesta per cui il ML conta — è che i sistemi che apprendono accorciano l'intervallo tra la comparsa di una nuova tattica di elusione e il suo rilevamento, passando da "quando qualcuno aggiornerà la lista" a "non appena il pattern emerge nei dati".
Prima il Deterministico, il ML per la Zona Grigia
Dopo tutto questo, un avvertimento contro l'eccesso opposto: il machine learning non ha reso obsoleta la validazione deterministica — ha reso la combinazione lo standard del settore. Dove una regola può decidere, deve decidere la regola: è più veloce, più economica, perfettamente spiegabile e immune al model drift. Nessuna stima di probabilità migliora "questo dominio non ha server di posta". La pipeline ben progettata è quindi a strati: prima i controlli deterministici, che risolvono istantaneamente la netta maggioranza dei casi; il punteggio di rischio basato su ML riservato al residuo di casi davvero ambigui.
| Dimensione | Solo Regole | Deterministico + Punteggio di Rischio ML |
|---|---|---|
| Indirizzi netti | Decisi in modo conclusivo | Decisi in modo conclusivo — stesse regole, stesso risultato |
| Zona grigia (catch-all, greylisting, ambiguità) | "Sconosciuto" o un'ipotesi forzata | Punteggio di rischio calibrato su cui fissare soglie |
| Nuove minacce (domini usa e getta recenti, pattern di bot) | Rilevate solo dopo l'aggiornamento delle liste | Generalizzate dai pattern infrastrutturali e comportamentali |
| Velocità di adattamento | Manuale — qualcuno deve scrivere la nuova regola | Continua — i modelli si riaddestrano su esiti di consegna aggiornati |
| Spiegabilità | Totale — ogni verdetto corrisponde a una regola | Alta per le regole; i punteggi richiedono report di calibrazione |
È con questo approccio a strati che è costruito AT Valid: oltre 20 controlli di verifica deterministici — tra cui sintassi, DNS, MX, verifica della casella a livello SMTP, rilevamento di indirizzi usa e getta e account di ruolo — risolvono ogni indirizzo che può essere risolto in modo conclusivo, e il punteggio di rischio basato su machine learning copre la zona grigia che le regole non possono decidere, garantendo un'accuratezza del 99,5% sull'intera pipeline combinata. Se validi nel punto di raccolta, la stessa logica a strati si applica in tempo reale; la nostra guida all'API di validazione email in tempo reale illustra i pattern di integrazione e i margini di latenza coinvolti.
Cosa Chiedere a un Fornitore di Validazione
Nel 2026 la dicitura "basato sull'IA" compare su quasi ogni pagina di prodotto di validazione, il che la rende inutile come elemento di differenziazione ed essenziale come spunto per le domande. Cinque domande separano la sostanza dall'etichetta:
- Come viene misurata la vostra percentuale di accuratezza? Rispetto a quale verità di riferimento — esiti reali di consegna o un set di test statico? Su quale mix di indirizzi? Un numero calcolato su indirizzi facili, decidibili tramite regole, non dice nulla sulla zona grigia in cui i servizi si differenziano davvero.
- Come vengono gestiti e conteggiati gli indirizzi catch-all? Ricevono un punteggio o finiscono in un contenitore "sconosciuto" — e quel contenitore è incluso o escluso dalla dichiarazione di accuratezza?
- Con quale frequenza vengono riaddestrati i modelli? Un sistema di apprendimento che ha smesso di apprendere è un sistema a regole con qualche passaggio in più. Chiedi la cadenza e quali dati aggiornati lo alimentano.
- Gli esiti di consegna vengono reimmessi nel sistema? È il ciclo degli esiti dei bounce a mantenere onesta l'accuratezza nel tempo.
- Posso vedere il livello di fiducia, e non solo il verdetto? Un servizio che espone i punteggi di rischio ti permette di regolare il compromesso tra precisione e recall in base al tuo caso d'uso, invece di ereditare quello del fornitore.
Il Vantaggio di AT Valid
AT Valid combina oltre 20 controlli deterministici con un punteggio di rischio basato su machine learning per gli indirizzi che le sole regole non possono decidere — accuratezza del 99,5%, valutazione del rischio dei catch-all inclusa. Crea un account gratuito e provalo su 200 indirizzi — nessuna carta di credito richiesta.
Conclusione
La validazione email sta vivendo la stessa transizione che il filtraggio antispam ha attraversato quindici anni fa: dalle regole scritte a mano ai sistemi che apprendono — non perché le regole abbiano fallito, ma perché il problema ha superato ciò che le sole regole riescono a esprimere. Lo strato deterministico continua a fare il grosso del lavoro, decidendo i casi netti in modo istantaneo ed economico. Lo strato di machine learning fa qualcosa che le regole non hanno mai potuto fare: assegna una probabilità difendibile e in continuo miglioramento al residuo ambiguo — i catch-all, i server con greylisting, il dominio registrato stamattina, l'indirizzo generato da un bot che sembra una persona.
Per i mittenti, la conclusione pratica è semplice. Giudica i servizi di validazione non dall'"IA" sull'etichetta, ma dall'architettura sottostante: prima il deterministico, il ML per la zona grigia, gli esiti che tornano nel sistema, l'accuratezza misurata con onestà. È questa combinazione a far davvero scendere il tasso di bounce — e con esso a proteggere la tua reputazione di mittente e i tuoi ricavi.
Vuoi vedere la validazione con punteggio di rischio sui tuoi dati? Inizia con 200 crediti gratuiti su AT Valid e trasforma la zona grigia della tua lista in decisioni che puoi difendere.